یک مطالعه جدید از دانشگاه میشیگان نشان میدهد مدلهای مولد هوش مصنوعی هنگام تولید متن غیرانگلیسی بهطور چشمگیری انرژی بیشتری مصرف میکنند، بین ۱.۴ تا ۱۸۰ برابر بیشتر، و برای آن زبانها ممکن است خروجیهایی با دقت پایینتری تولید کنند. پژوهشگران گزارش میدهند که مدلهای هوش مصنوعی برای تولید متن غیرانگلیسی بین ۱.۴ تا ۱۸۰ برابر انرژی بیشتری مصرف میکنند.
یافتهها و دامنه مطالعه
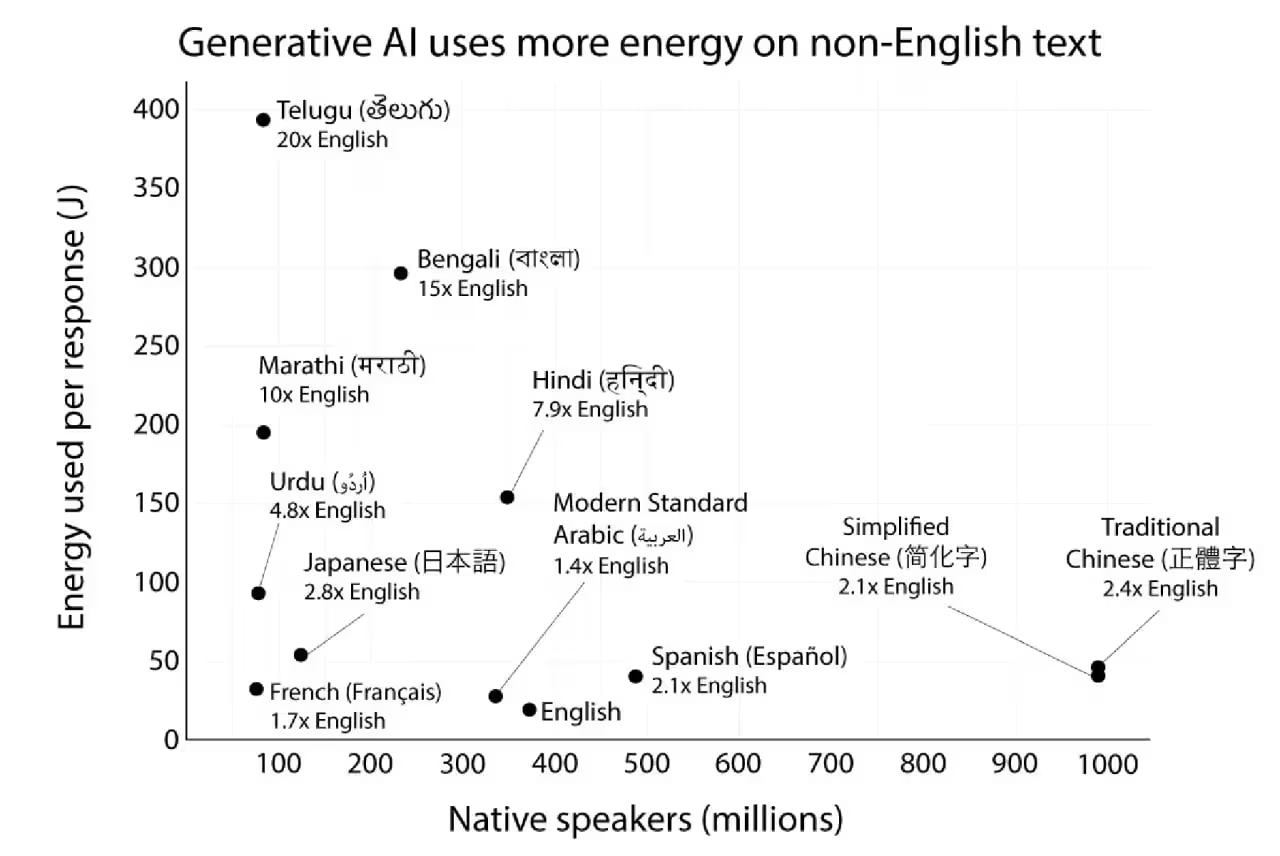
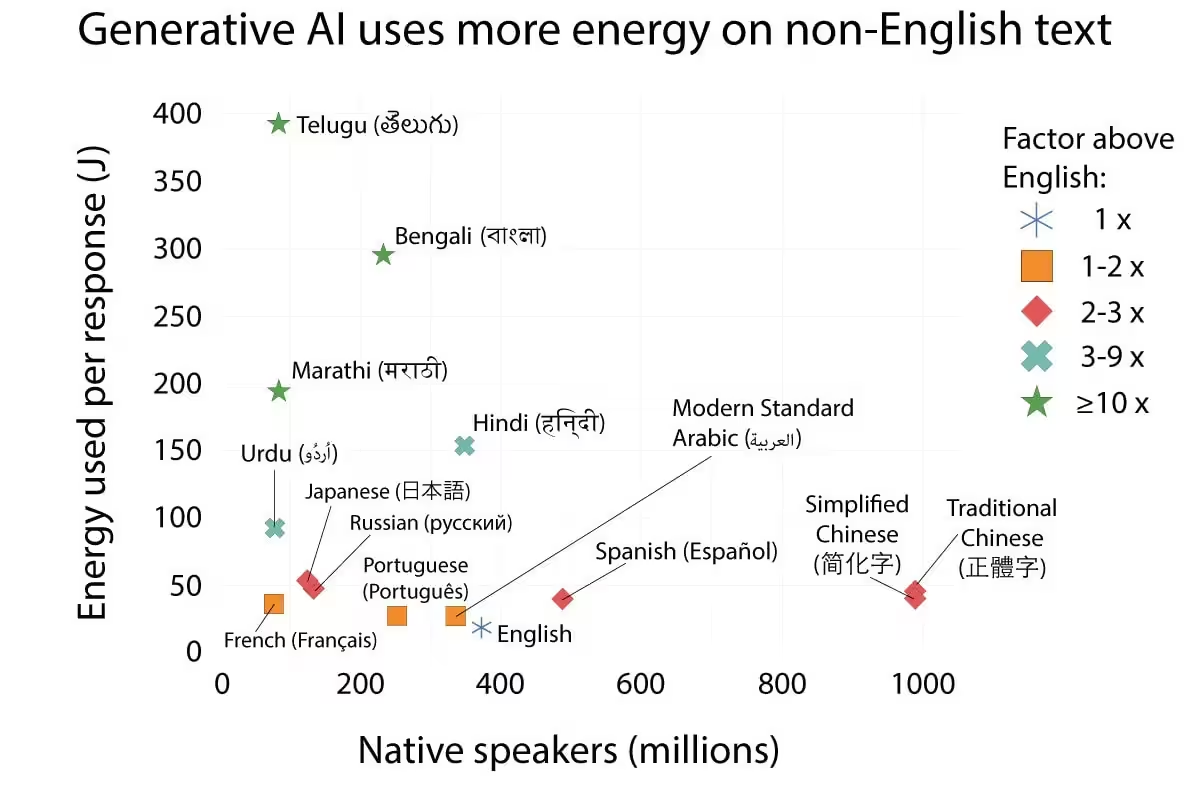
این پژوهش که در کنفرانس EMNLP ارائه شد، مصرف انرژی تولید متن را در زبانهای مختلف اندازهگیری کرد و بزرگترین شکافها را در زبانهایی یافت که از الفبای لاتین استفاده نمیکنند و دادههای آموزشی دیجیتال کمتری دارند. بهطور میانگین، مدلها برای تولید متن غیرانگلیسی به ۱.۴ تا ۱۸۰ برابر انرژی بیشتری نسبت به انگلیسی نیاز دارند. زبانهای غرب اروپایی حداکثر حدود دو برابر پرهزینهتر از انگلیسی بودند، در حالی که هندی و بنگالی بهترتیب به ۷.۹ و ۱۵.۳ برابر انرژی نیاز داشتند. نویسندگان تخمین میزنند که حدوداً ۵.۲ میلیارد نفر در سراسر جهان برای تولید متن به زبان مادریشان نسبت به انگلیسیزبانان بیش از دو برابر انرژی لازم دارند.
نایهاو دنگ، دانشجوی دکترای علوم و مهندسی کامپیوتر در دانشگاه میشیگان و نویسنده اول مقاله، میگوید زبانهایی که انرژی بیشتری مصرف میکنند معمولاً دقت مدل کمتری هم دارند. او این اثر را «مجازات دوگانه» توصیف کرد که میتواند دسترسی کاربران را که با هزینههای بالاتر روبهرو هستند محدود کند و انگیزه شرکتها برای پشتیبانی از برخی زبانها را کاهش دهد.
روشها، مدلها و اندازهگیریها
برای سنجش این شکاف، تیم سه مدل متنباز را ارزیابی کرد و با یک چارچوب اختصاصی مصرف انرژی را اندازهگیری نمود. مدلهایی که آزمایش شدند عبارت بودند از:
- کیون ۳ (علیبابا)
- جما ۳ (گوگل)
- لاما ۳.۱ (متا)
پژوهشگران از مجموعهداده بلِبلِ (Belebele) استفاده کردند، که درک مدل را در ۱۲۲ زبان ارزیابی میکند، و چارچوب اندازهگیری امال.انرژی را بهکار گرفتند. آنها سوالات چندگزینهای، مسائل ریاضی و درخواستهای متنی آزاد را اجرا کردند. نتایج نشان داد هر سه مدل بهطور میانگین انرژی کمتری برای درخواستهای انگلیسی مصرف کردند و این اختلافها در اندازههای بزرگتر مدل و روی پردازندههای مختلف نیز پابرجا بود.
علل و توضیح فنی
علت فنی اصلی، توکنیزهسازی است. توکنها واحدهای پایه دادهای هستند که مدلها پردازش میکنند؛ متن قبل از محاسبه به توکنها تبدیل میشود. زبانهایی مانند هندی و نپالی که در آنها حروف شکلشان تغییر میکند یا با علائم اعرابی ترکیب میشوند، برای یک محتوای معنایی یکسان توکنهای بسیار بیشتری تولید میکنند. تولید توکنهای بیشتر مصرف حافظه را افزایش میدهد که مدلها را مجبور میکند توکنها را در دستههای کوچکتری پردازش کنند. دستههای کوچکتر مصرف انرژی به ازای هر توکن را افزایش میدهد و توان عملیاتی را کاهش میدهد. از آنجا که بسیاری از ارائهدهندگان دسترسی را بر اساس شمارش توکنها صورتحساب میکنند، کاربران غیرانگلیسی ممکن است هزینههای مستقیم بالاتری نیز متحمل شوند.
پیامدها و راهکارهای پیشنهادی
این مطالعه یک منبع بالقوه نابرابری دیجیتال جهانی را برجسته میکند: کاربران بسیاری از زبانهای غیرلاتین و زبانهای کممنبع ممکن است بابت انرژی و هزینه پول بیشتری بپردازند و خروجیهای با کیفیت پایینتری دریافت کنند. برای رفع این نابرابری، پژوهشگران توصیه میکنند شرکتهای هوش مصنوعی خدمات خود را برای مجموعهای گستردهتر از زبانها بهینهسازی کنند، برای مثال با هدایت پرسوجوها به مدلهای خاص زبان یا ترجمهٔ پرسشها به انگلیسی قبل از پردازش در مواقعی که مناسب است.

.avif)
نظر بگذارید
نظرات
هنوز نظری ثبت نشده. اولین نفر باشید.